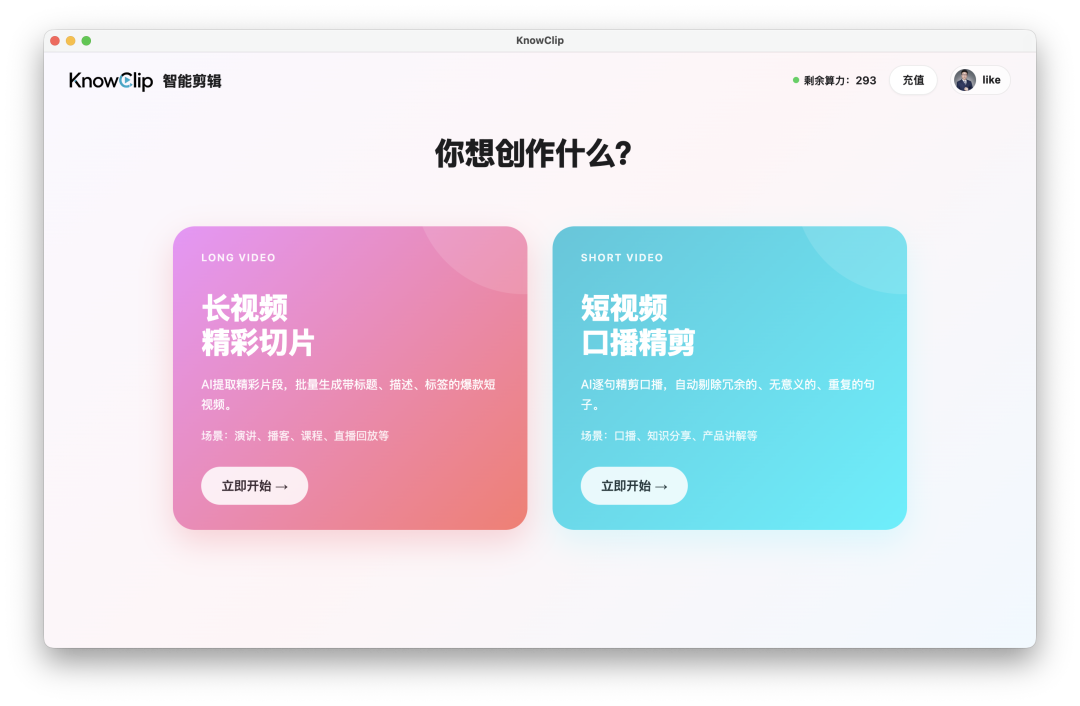
我想让 AI 替我干一件体力活:把一节三小时的课,自动切成十几条短视频。
老师录完课,最烦的就是这个——干货都在,但人工翻三个小时找金句、下刀、导出,一天就搭进去了。这事 AI 可以代劳:听懂课、找到精彩片段、切出来。
真动手才发现,"切"是最简单的一步,难的是"听"。AI 要替人干活,得先有感知器官;剪视频这个活,它需要的器官是耳朵——得先听懂三个小时里人说了什么、每句话是第几秒说的,才谈得上哪里精彩、刀往哪落。
所以做 AI 剪辑的第一步,是给 AI 装一双耳朵。这篇讲我装这双耳朵的过程。
一、剪视频要的"听懂",比语音输入法难得多
你可能会说,语音转文字不是早就有了吗?
对,但剪视频要的"听懂",门槛高得多,三条:
素材脏。课程录像、直播回放、现场演讲,全是真人开口的中文口语,带环境噪声,还夹着成吨的"呃""这个""对吧"。
标点必须齐。转出来的文稿直接能用,不让用户再校对一遍。
第三条最要命:每个字都要标出是第几秒说的(行话叫字级时间戳)。因为 AI 后面照着时间戳下刀,时间戳不准,切出来的片段会把一个词劈成两半——"人工智"丨"能",观众看着就别扭。
听得懂口语、记得住时间、扛得住三小时连轴转。我拿着这三条去给 AI 找耳朵。
二、两个候选
候选一是 Whisper,OpenAI 开源的,支持几十种语言,生态最成熟。候选二是 Paraformer,达摩院开源的,主打中文场景。
我把自己手里的课程录像、直播回放挨个喂给它们跑。先说明一句:以下都是我在"中文长视频"这个场景下的实测,不是权威评测,你的场景结论可能不一样。
三、一个根本差别:写字的方式
两个模型最根本的区别,是生成文字的方式。
Whisper 是一个字一个字往外写的,而且每写下一个字,都要参考前面已经写出的所有字——写第 100 个字之前,必须先写完前 99 个。这种方式叫"自回归"。它像一台打字机:哒哒哒,一个字一下,质量稳,但三千字的文稿就得走三千步,一步省不了。
顺便说,你平时用的聊天大模型也是这么干活的——看着它在屏幕上逐字往外蹦,就是自回归在运行。
Paraformer 反过来:听完一整段,整段文字一口气写出来,所有字同时算出来,不是一个接一个蹦的。这叫"非自回归"。它像一个默写高手:看完题,整段答案直接落在纸上,字再多也是一遍过。
后面测出来的速度差距,根子就在这里。
四、各自的代价
跑完实测,两边的长短很清楚了。
Whisper 的强项在多语言和英文,模型久经考验,社区里什么问题都搜得到答案。代价是:大模型太大,普通电脑跑不动;换小号模型,中文识别率明显下滑,标点时有时无,偶尔简繁混杂;字级时间戳是事后推算出来的,估的,音频一长就漂;遇到长静音、背景音乐,模型还可能"幻听"——同一段话重复输出十几遍,整份字幕直接废掉。
Paraformer 的强项恰好都对在我的需求上:中文语料训练,标点有专门的模型负责补;字级时间戳是模型原生输出的,不用推算;配套工具里有 VAD 模块,作用是把"有人在说话"的段落先挑出来,静音和音乐不进识别环节,几个小时的整场处理本来就是它的设计场景。代价是:它主要为中文优化,多语言不是它的目标,社区规模也比 Whisper 小得多。
综合考虑,我的场景是中文、长音频、要精确时间戳、还要在普通电脑上跑——我选了 Paraformer。如果哪天要做英文素材的工具,我会回去找 Whisper。
五、模型定了,坑才刚开始
真正花时间的,是选型之后那些不起眼的坑。
有一次,转写文稿结尾冒出一串孤零零的",。,。"。我排查了半天:语音结束后的环境噪声被 VAD 误判成人声放了行,标点模型照常工作,产出一段只有标点、没有字的"句子"。解法是把不含文字的段落过滤掉——不难,但你得先踩到它。
再说幻听,这其实就是语音识别版的"AI 幻觉"——和大模型一本正经地编答案是同一类毛病。VAD 也拦不干净,个别素材就是会重复输出。我对症写了个去重算法:在字的时间序列里找最长的相邻重复片段,顺着数出重复了几遍,只留一份。这个算法展开讲挺有意思,以后单独写一篇。
这些坑跟模型强弱关系不大,跟你愿不愿意一段段音频去试、一行行文稿去对,关系很大。用 AI 干活,这大概是常态:模型出的初稿,总得有人替它收拾残局。
全部踩平之后,这套方案在我的苹果电脑上跑出了 80 倍速:一小时音频,45 秒转完,字级时间戳一个不缺。
六、赢了技术,却拐了个弯
故事到这儿本该圆满了。做正式版软件时,撞了两堵墙。
第一堵,体积。识别、VAD、标点,三个模型加起来好几个 G,对于正式版的分发非常不友好。
第二堵,用户的电脑。没有独立显卡、内存紧张的老机器才是大多数。我开发机上顺滑的方案,到了用户电脑上可能就是卡死。
说实话,刚把本地这条路跑通就要亲手拆掉,心里是不甘的。但软件是做给用户用的,不是做给跑分截图用的。
最后的方案:识别放到云端,云端恰好有同款技术路线的服务,识别效果和时间戳原样保留。上传的只有音频,加密传输,识别完即删;视频画面从头到尾不出本机。
走完这一程我才想明白:选什么模型,和最终怎么部署,是两件事。本地跑出 80 倍速,不代表它适合每一台用户的电脑;转云端,也不意味着当初的选型白做了。
七、那套"用不上"的本地方案,我开源了
转向云端之后,那套本地方案在正式版里用不上了。但它是我一段段音频喂出来、一个坑一个坑踩平验证过的,让它烂在硬盘里,我觉得可惜。
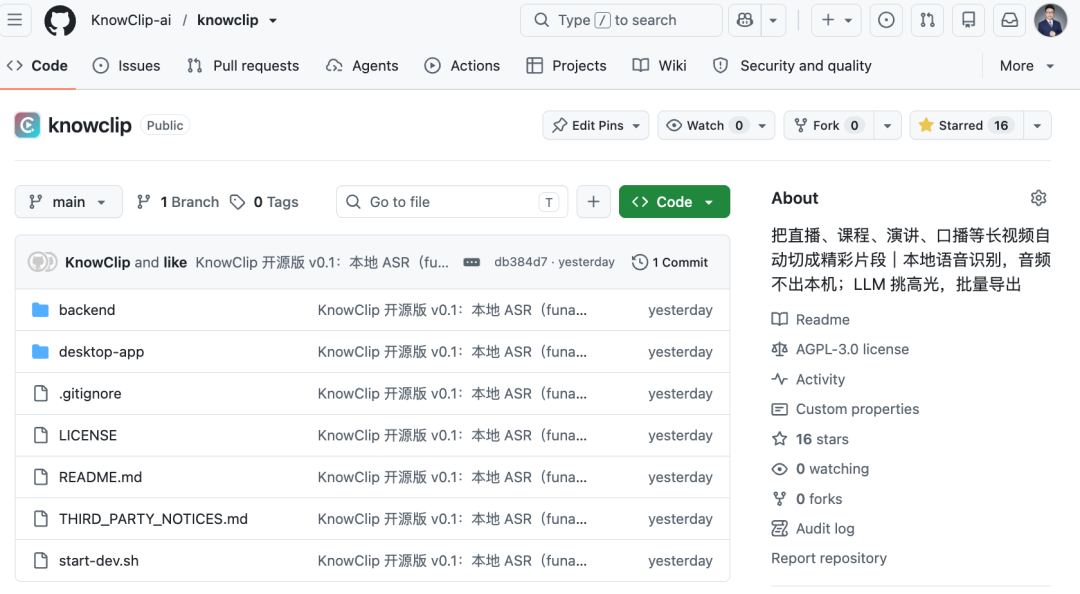
所以我把核心链路整理出来,开源到了 GitHub:选视频、本地识别、AI 挑片段、切片导出,都能跑通。它不是演示用的代码,是能够直接应用于生产力的工具。
我自己学新东西的时候,最希望的就是有人留一份能跑的开源代码,现在轮到我留了。
把这套流程交给 AI
KnowClip 智能剪辑,macOS / Windows 免费下载。视频本地剪辑导出不上传,只有云端语音识别按用量计费,无订阅、无水印。