用过 AI 剪辑工具的人,大概都骂过两件事:贵,和慢。分析一次几十块,还得排队二三十分钟。
我自己做的这个工具叫 KnowClip,三小时的视频,3 秒钟分析完,一次几毛钱,顺带剪出几十条片段。
差别不是谁家 AI 更聪明,是干活的方式不一样。这篇讲讲这条路是怎么定的,中间我被 AI 结结实实坑了几回,顺便聊聊"AI 为什么会干出这种事"——弄明白这个,你用任何 AI 工具都会心里有数。
一、贵和慢,是路径决定的
先说那些工具为什么贵。它们的做法是:你把整个视频传上去,平台用能看画面的 AI 模型(视觉模型)逐段看画面、听声音,再判断哪里精彩。
这条路的成本是天然的。视频文件本来就大,AI"看片"的计费又贵——模型按它处理的内容量算钱,一段视频的信息量顶几十万字的书。大家都这么传,服务器还得排队。
我的做法不一样:不让 AI 看视频,让它读稿子。
上一篇讲过,我先给工具装了"耳朵",把视频里的人声转成带时间戳的文字稿。到了"挑精彩片段"这一步,AI 要判断的只是"这段话精不精彩"——这是个纯文字活。
三小时的课,转成文字稿也就几万字。现在 DeepSeek 这类文本模型读几万字,几秒钟的事,一次几毛钱。这就是 3 秒和三十分钟的差距从哪来。
二、让 AI 挑片段,难在让它说清楚挑了哪段
省钱只是第一步。真让 AI 挑起来,我发现难的不是"挑",是让 AI 说清楚它挑了哪段。为这事我换了三版方案。
第一版,让 AI 报时间。它说"1 分 23 秒到 2 分 05 秒这段不错",我照着时间去切。结果一切就错位——AI 写数字经常是估的,它说 1 分 23 秒,那句话可能实际从 1 分 31 秒才开始。切出来的片段,不是开头少半句,就是结尾多半句。
第二版,让 AI 抄原文。我想通了:AI 的长处是理解语义,不是背数字,文字才是它的母语。改成让它把认为精彩的段落整段抄下来,我拿这段文字回逐字稿里查出处,时间戳自然就有了。结果它有职业病——抄着抄着,忍不住顺手帮你改错别字、顺句子,交回来的段落和原稿总差着几个字,还是对不上。
第三版,模糊匹配。最后上了个兜底机制:AI 抄回来的段落,哪怕改了错别字、换了标点,我也能拿它和原稿做模糊比对,找到最像的位置,把精确时间戳定下来。
到这儿分工就清楚了:AI 只负责判断"哪段精彩",这是它的强项;定位"这段在第几秒"交给程序,这是程序的强项。
三、这不是我运气差,是大模型的通病
踩完这几个坑我琢磨过一个问题:AI 为什么这么简单的两件事——报准一个数字、照抄一段话——都做不好?
因为它干活的方式决定了它天生不擅长这个。大模型本质上是在"接龙":一个字一个字地预测,下一个最可能是什么字。它追求的目标从来不是"精确复刻",而是"看起来像人话"。
拿这个视角看,我踩的两个坑就全解释通了。报时间戳为什么会估?因为"1 分 23 秒"对它来说不是数据库里能查的格子,是要现场编出来的一串字,编个差不多的就交差了。抄原文为什么忍不住改错别字?因为在它的标准里,"更通顺的版本"才是好答案,原稿里的语病它看着难受。
这两年大家对"AI 幻觉"讨论得很多——大模型一本正经地编参考文献、编不存在的新闻,根源是同一个:它把"听起来合理"当成了"事实"。有研究就说得很直白:现在的训练和考试机制奖励"敢答",不奖励"承认不知道",模型宁可猜一个也不空着。
所以这不是哪家模型笨,是所有大模型的通病。你让 AI 写总结、出主意、做判断,它是高手;你让它当复印机、当尺子,它一定会出错。工程上正确的姿势不是期待它变乖,是一开始就别让它干它不擅长的活。
四、想清楚 AI 该干什么
走完这三版,我才算明白用 AI 干活的关键:不是让它包办一切,是分清楚它擅长什么、不擅长什么。判断交给 AI,精确交给程序。
上一篇说,选什么模型和最终怎么部署,是两件事。这一篇的教训是:让 AI 干什么、不让它干什么,同样得想清楚。
五、最后
到这里,工具的链路就通了:耳朵听懂课,脑子挑出精彩段落,剩下最后一环——照着时间戳下刀,把片段又快又准地切出来。怎么做到毫秒级下刀,是下一篇的故事。
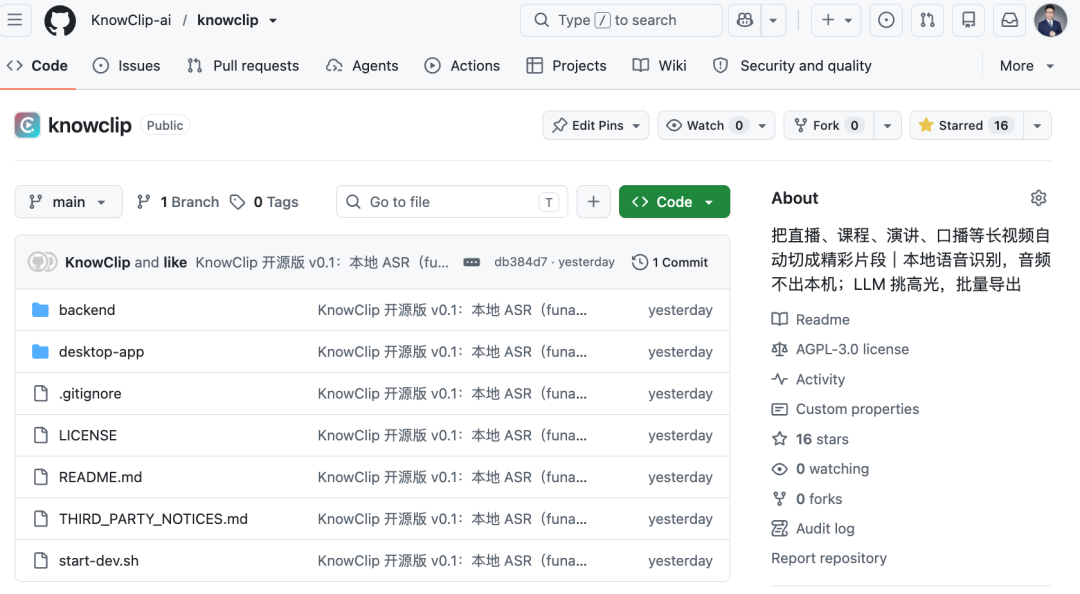
这套挑片段的实现,我在GitHub开源了,有完整代码供你学习。
把这套流程交给 AI
KnowClip 智能剪辑,macOS / Windows 免费下载。视频本地剪辑导出不上传,只有云端语音识别按用量计费,无订阅、无水印。