前面三篇,耳朵、脑子、下刀,都齐了。直到我把一条横屏课程切成竖屏——老师往左走了两步,人没了。
这个功能我前后做了四个月,推翻了自己三次。它是整个工具里我花时间最多的一环,今天完整讲一遍。
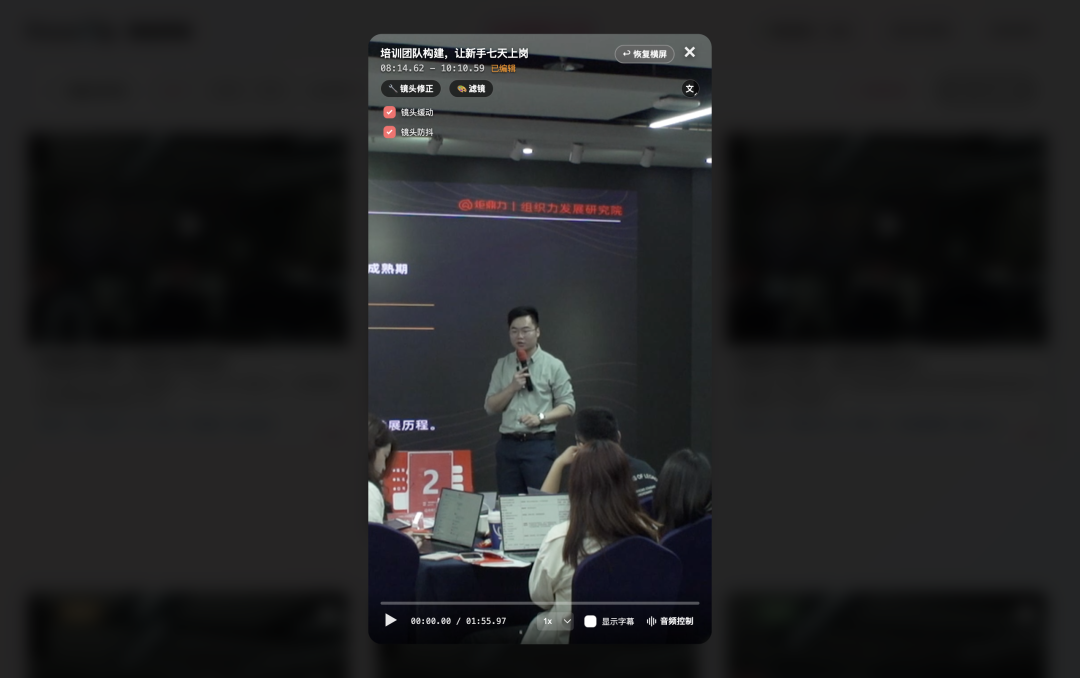
一、横转竖的真面目:请一位虚拟摄像师
横屏是宽的,竖屏只留中间窄窄一条,宽度大约三分之一。
人站着不动还好办,把窄条钉在正中间就行。但讲课的人会走动、会写白板、会走到讲台另一边。窄条不动,人就出画了。
所以横转竖的真面目是:请一位"虚拟摄像师",每一帧重新决定——这条窄画面,此刻对准谁。
难点不在"找到人"。第一帧找到人很容易,难的是接下来几万帧,一直跟住同一个人。
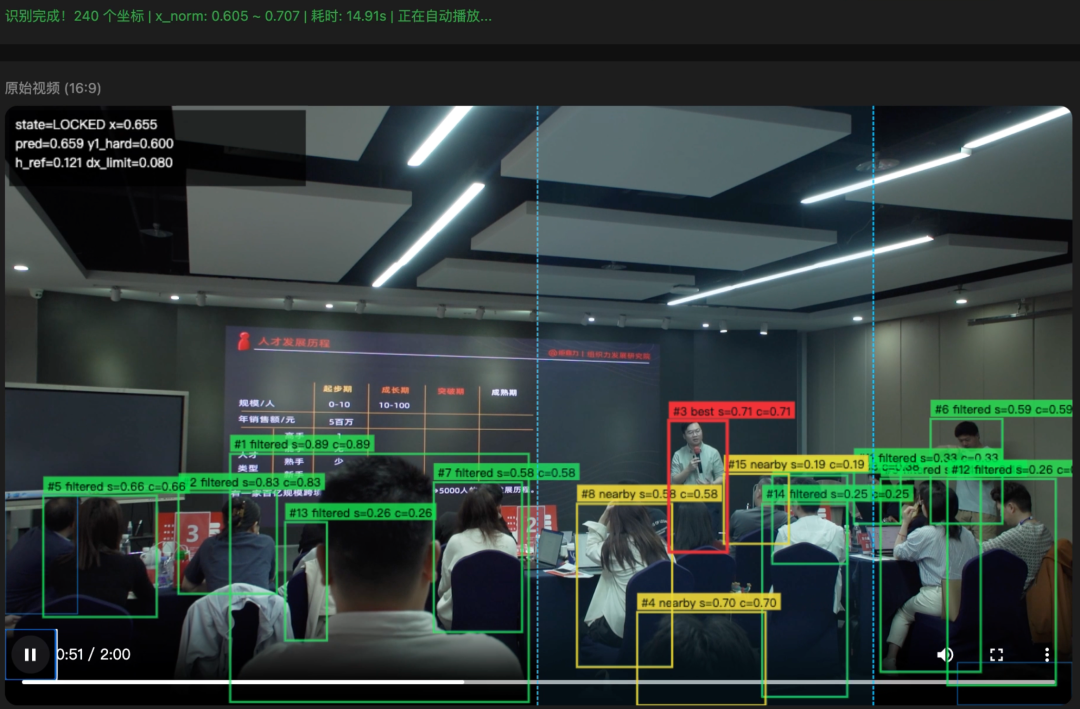
二、第一代:追脸,一天破产
最直觉的思路:认脸。脸在哪儿,镜头跟哪儿。人脸检测是成熟技术,手机上遍地都是。
实际一跑就死。课堂录像里,老师一半时间背对镜头写白板——画面里根本没有脸。侧身、走远、低头,脸要么消失,要么糊成几个像素。
手机那套是为自拍设计的,课堂是另一种动物。
要追的是"人",不是"脸"。这个方案当天就进了垃圾桶。
三、第二代:立规矩,和"抢镜者"斗了一周
改认全身:先检测画面里所有的人,再想办法锁定其中一个。
为了省算力,我让系统每秒只抽两帧来看。真正的摄像师盯着取景器一眨不眨,我的这位每秒才睁两次眼——这个节省,后来成了半个灾难的源头。
动手前我先立了条铁律:允许一开始错,不允许中途跳变。开头锁错了人,用户点一下就能换人;中途从老师跳到路人身上,整条片子就废了,没法救。
然后是整整一周的战争。对手是各种各样的"抢镜者"。
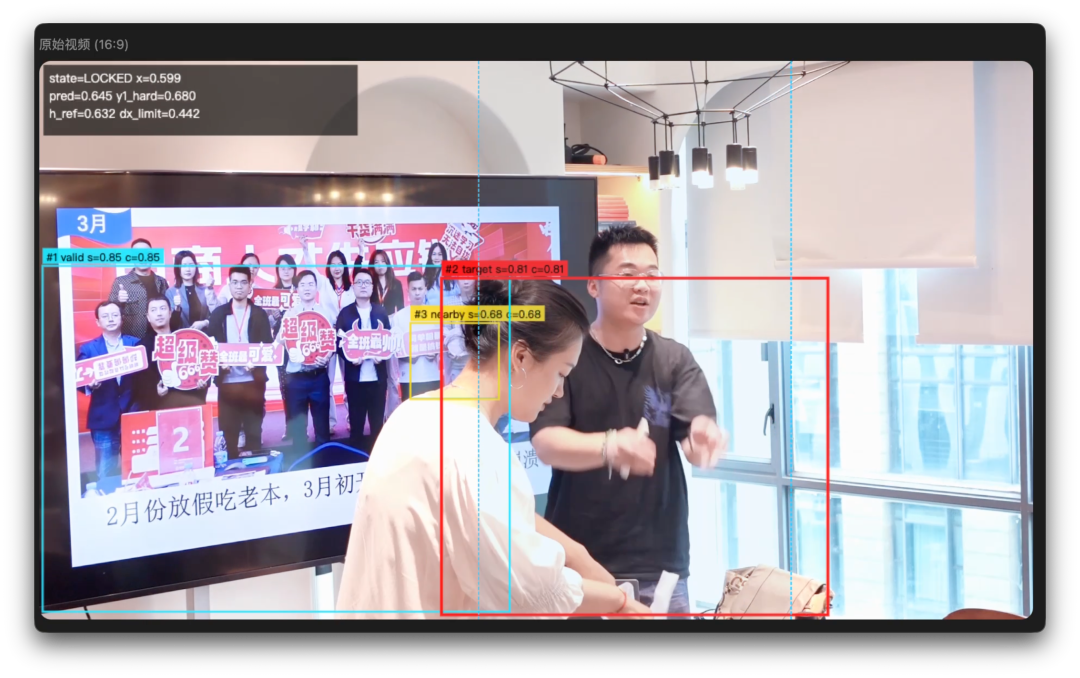
白衣女士。 老师被路人挡了 0.5 秒——别忘了系统每秒只睁两次眼,一睁眼,老师没了,旁边杵着一位白衣女士,镜头就跟她走了。更糟的在后面:我备的保险是"出错了就回滚到之前的安全位置",可那个位置队列早被白衣女士污染了。回滚,等于滚向错误的人。越修越糟,最后镜头锁到了电视屏幕的反光上。
PPT 合影。 老师出画十几秒,系统锁定了 PPT 里的一张合影照片,整整 13 秒。站在算法的角度这很合理:照片一动不动,边界清晰,比会动的真人更"像人"。
屏幕影子。 老师低头写板书,身高骤降,系统判断"换人了",开始重新找——屏幕上的人影刚好出现在预测位置附近,得,锁影子上了。后来才分清:人低头会变矮,但不会变"扁",比例不对的是影子。
摄影师和老师快走的死结。 这是最难的一个。老师快走两步,和摄影师闯入画面,在每秒睁两次眼的系统看来几乎一模一样。任何"放宽一点"的规矩都会被摄影师利用,收紧一点老师又跟丢。解法是给摄像师加"预判":不只看你这一帧在哪,还看你是不是按之前的方向和速度在走。老师走得再快,轨迹是连贯的;摄影师是横插进来的。改完,一段 60 秒的快走镜头从卡死变成全程跟住。
这一周我还试过一条捷径:记衣服颜色认人。被证伪了——黑衣老师和白衣女士的"颜色特征"算出来相似度高达 0.67,而且老师今天黑 T、明天白 T。当时的技术文档第一节标题就叫"为什么放弃颜色"。
到 5 月 1 日,我拿着五个最刁钻的测试片段挨个跑:遮挡、出画、多人、快走、影子,全部不跟丢。我在文档里写下"可用版"三个字,以为赢了。
四、插曲:上线当天,我自己把它撤了
五月中旬。用着用着发现不对:它在我的测试片段中可用了,但是换成别的片段又不行了。于是,上线当天我就回滚了。
五、第三代:承认天花板,让 AI 真正"认识"这个人
七月重启。我先是又把老路走了一遍——再给颜色一次机会,结果第二次被证伪。这下死心了。
盯着那堆缝缝补补的规矩,我承认了一件事:阈值立得再多,系统其实根本不认识这个人,它只是在跟"一个会动的框"较劲。这是启发式的天花板。
于是我推翻了自己最初的约束,换思路:让模型给画面里每个人算一个"长相指纹"。
所谓指纹,是一串数字。同一个人,正脸、侧脸、背影,算出来都差不多;不同的人,差得远。每次睁眼,各算各的指纹,谁的最像 IP 本人,镜头跟谁。影子没有指纹;照片里的人有指纹,但和真人老师对不上;白衣女士也有自己的指纹——再也抢不走镜头。
这套组合是"一个检测模型找人、一个识别模型认人"(YOLOv8 + ReID)。后者学名行人重识别(re-identification),本来是监控领域在人群里找人的技术。
真用起来还有讲究:同一个人得存好几份指纹档案——正脸一份、侧脸一份、背影一份,不然老师一转身,指纹对不上,又算"换人"。
六、一个意外惊喜:你电脑里有一块芯片,一直在睡大觉
新方案多一个模型,视频几万帧帧帧要认,算力账必须先算平。一开始我用的是苹果的 GPU——跑图形的那块芯片,行话叫 MPS,用它能跑,但有点勉强。
八月五号那天,我抱着试试看的心态写了个跑分脚本,让同一个模型分别在 CPU、GPU、还有第三样东西上跑一遍——NPU,苹果芯片里专门跑 AI 的那块,行话叫神经网络引擎。
结果把我看乐了:认一次人,GPU 要 9.76 毫秒,NPU 只要 1.70 毫秒,快了近 6 倍。而且两条路算出来的指纹一模一样(相似度 1.0000),不是偷工减料的快。
说实话我之前压根没想起这块芯片。它就在每一台近几年的 Mac 里,但绝大多数软件从生到死没用过它一次——它一直在睡大觉。很多用户也不知道自己电脑里还有这么个东西。
这是我做这个项目最赚的一次"试试看"。也提醒我自己:别默认 GPU 就是最快的,硬件厂商早就为 AI 单独备了一块地,就看你绕不绕得过去。
七、工程化的坑:预览里都对的,导出全错了
八月,算法集成进正式版,我以为终于到头了。然后是三个让我哭笑不得的坑。
预览丝滑,导出顿挫。 预览里镜头已经稳稳的,导出的成片却一格一格地顿:连续几帧不动,突然跳一下,像有人在背后一帧帧拽着镜头走。查到最后,导出那一步把镜头坐标四舍五入成了整数像素:移动 0.3 像素记 0,攒够 1 才跳。预览走的是小数所以丝滑,导出把小数扔了就成了阶梯。修复一句话:别取整。但为了确认是这个问题,我写了个脚本用波浪线模拟人物走位,把每一帧的跳动量打出来对。
双击启动,进度条永远 0%。 在我电脑终端里跑得好好的,打包成 App 双击图标启动,追焦永远卡在 0%,一行报错都没有。查到最后:双击启动的程序拿不到终端里的环境配置,找不到 ffmpeg,抽帧那一步悄悄死了。用户视角是"软件坏了",我视角是"环境差了一个变量"。
镜头钉死在画面左边。 竖屏转出来了,但镜头纹丝不动钉在最左。原因是前端和后端对同一个坐标用了不同的字段名——最低级的坑,也最真实。集成这种事,永远有意想不到的地方会松。
八、最后实现了什么
折腾四个月,现在这套追焦是这样的:
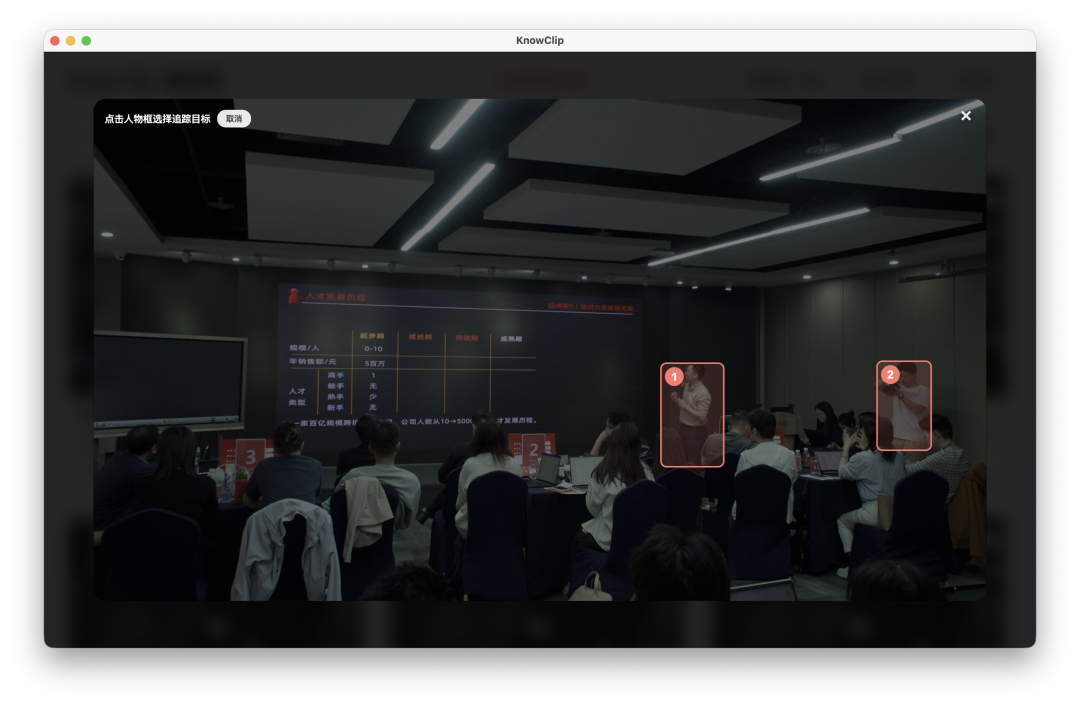
你点一下画面里的 IP 本人,镜头就锁死了他——人走到讲台边,镜头跟到讲台边;多人同框、被路人挡、转身写白板,都不跟错。取景基于原始分辨率逐帧裁,不先压缩再裁剪,画质不打折。
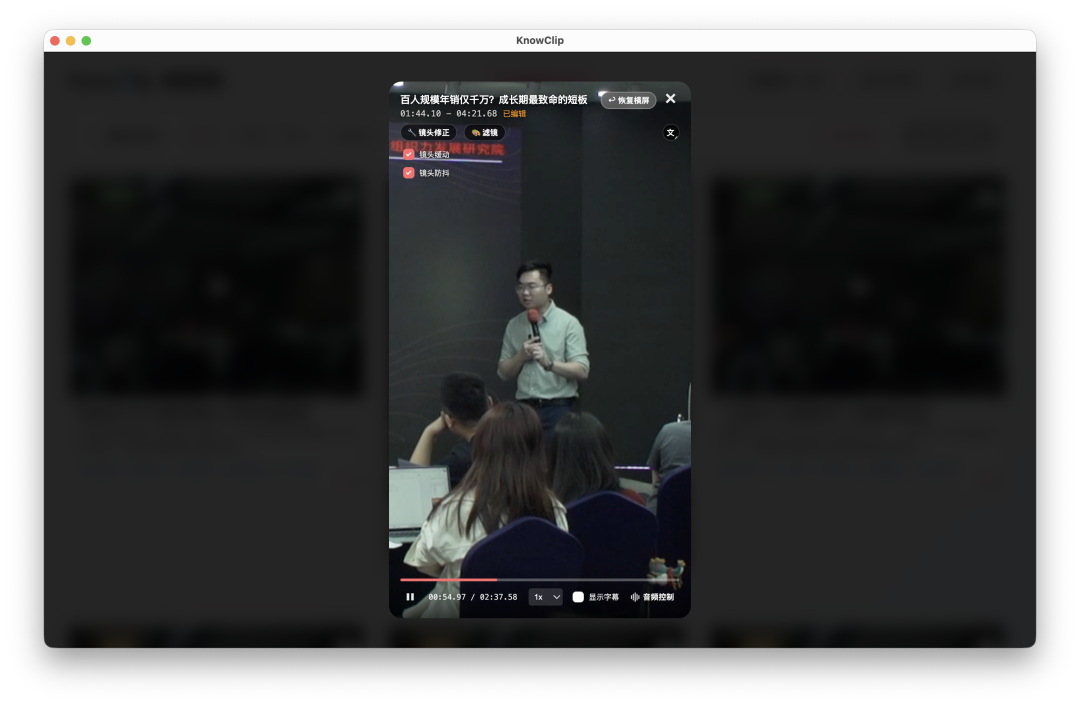
运镜手感也是调出来的。同一个平滑系数,我来回调了四回——手感这东西,数字差一点,眼睛看得出来。最后留了两个开关给用户:"镜头缓动",画面缓入缓出,像真人摄像师的呼吸感;"镜头防抖",压住人物移动和镜头移动叠出来的晃动,画面稳。
四篇写下来,哲学是同一条:判断交给 AI,精确交给程序,选择权握在人手里。这位摄像师再聪明,也是给人打副手的。
最后坦白一件事:追焦是 KnowClip 完整版的能力,不在开源版里。开源版是"听懂 → 挑片段 → 导出"这条主链路的精简学习版,放在 GitHub 上,供大家学习。
把这套流程交给 AI
KnowClip 智能剪辑,macOS / Windows 免费下载。视频本地剪辑导出不上传,只有云端语音识别按用量计费,无订阅、无水印。